Nowy standard w danych dla manipulacji dwuręcznej
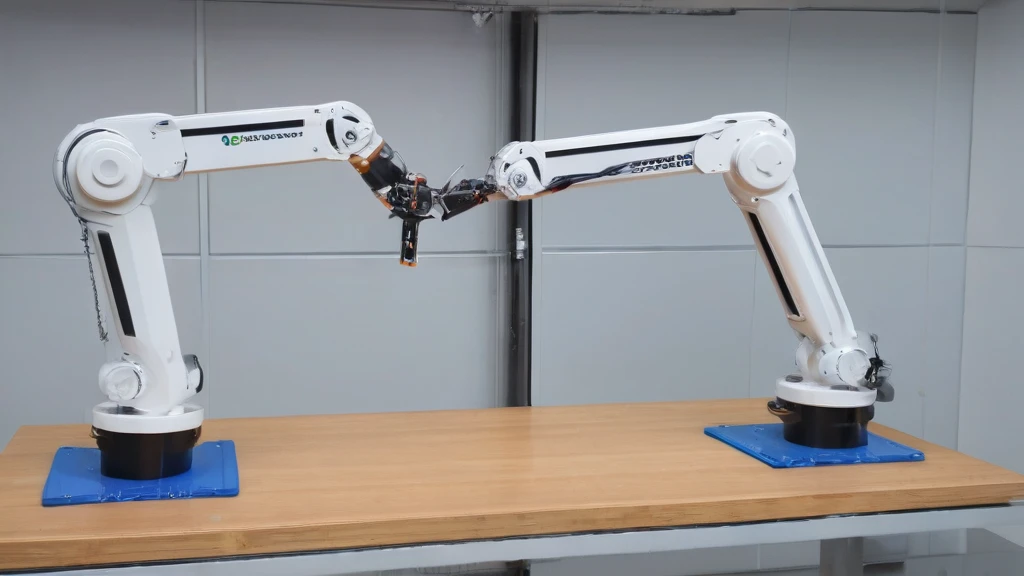
FineART to najobszerniejszy dotąd zbiór danych dla robotów wykonujących zadania dwuręczne. Zawiera 40 543 epizody, co odpowiada 1 718 godzinom działania i ponad 533 tysiącom podzadań rozłożonych na 151 różnych zadań. W przeciwieństwie do wcześniejszych zbiorów danych, które często zawierały tylko jedno polecenie najwyższego poziomu na epizod, FineART oferuje szczegółową anotację każdego kroku - co znaczy, że każdy ruch i decyzja są dokładnie zapisane. To pozwala modelom uczyć się nie tylko „co zrobić”, ale też „jak to zrobić” w kontekście konkretnego zadania.
Taka głęboka anotacja jest kluczowa dla rozwoju robotów, które muszą działać w realnych środowiskach - np. Robotyka w produkcji addytywnej, rehabilitacji czy domu - gdzie nie wystarczy jedno polecenie, ale potrzebne są złożone, wieloetapowe działania. Zbiór danych został otwarty dla społeczności naukowej i będzie dostępny na Hugging Face, co umożliwia badaczom i inżynierom testowanie nowych podejść bez konieczności zbierania własnych danych.
Model FineART-VLA: uczenie się przez przewidywanie kolejnych kroków
Wraz z modelem danych wprowadzono również FineART-VLA - politykę wizyjno-językowo-działaniową, która potrafi przewidywać następne podzadanie w trakcie działania. Zamiast oczekiwać na pełne polecenie od użytkownika, model sam decyduje, co zrobić dalej, opierając się na obrazie i kontekście. To podejście, znane jako mid-training, pozwala na znacznie szybsze uczenie się i lepszą adaptację.
Badania pokazały, że w zadaniu rozstrzygania przestrzennego - gdzie robot musi określić, który z dwóch podobnych obiektów należy przesunąć - skuteczność wzrosła z 32,0% do 100,0%. Dodatkowo, po minimalnej dopasowaniu na nowym robocie, model potrzebuje dziesięć razy mniej danych niż tradycyjne modele bez mid-training. To oznacza, że rozwój systemów dla nowych urządzeń może być znacznie szybszy i tańszy.
Zero-shot generalizacja - klucz do elastyczności robotów
 Powiększony obrazZamknij powiększeniePoprzedni obraz
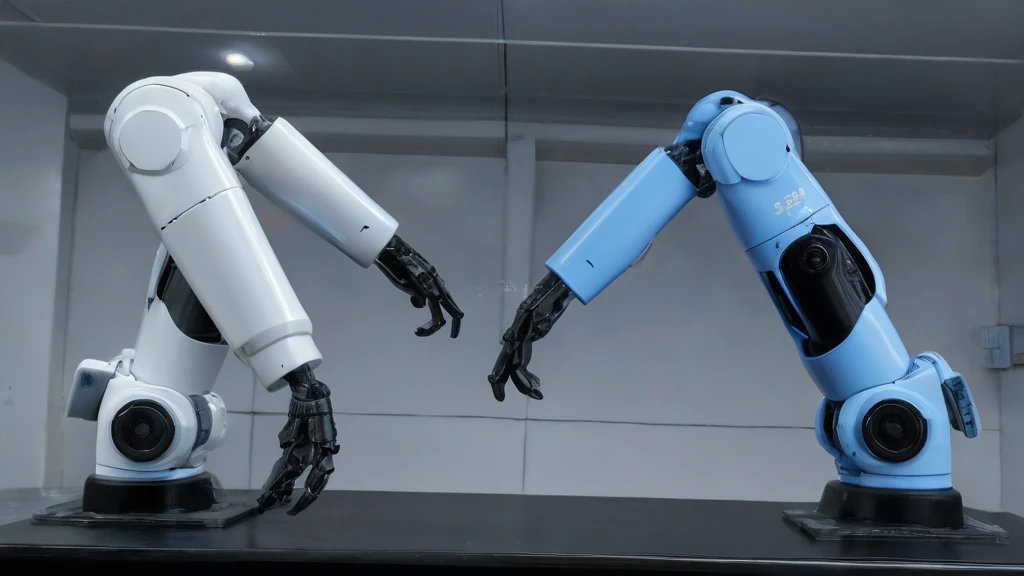
Jednym z najważniejszych osiągnięć FineART-VLA jest jego zdolność do zero-shot generalizacji. Model potrafi działać na całkowicie nowych zadaniach i na nowym sprzęcie bez konieczności dodatkowego uczenia się na danych z tego urządzenia. To oznacza, że po jednym razie dopasowania może być używany w różnych kontekstach - np. w fabryce, w klinice lub w domu - bez potrzeby ponownego zbierania danych.
Taka elastyczność jest kluczowa dla rozwoju robotów, które mają działać w zróżnicowanych i dynamicznych środowiskach. Zamiast tworzyć osobne modele dla każdego urządzenia czy zadania, można wykorzystać jedno rozwiązanie, które się uczy i dostosowuje. To zmniejsza koszty, skraca czas wdrożenia i otwiera drogę do bardziej niezależnych systemów.
Znaczenie dla przyszłości robotyki
FineART i FineART-VLA to nie tylko nowe narzędzia badawcze, ale też potencjalny krok naprzód w rozwoju robotów real-world. Dzięki szczegółowym danym i technikom uczenia się, które pozwalają na szybkie przystosowanie do nowych zadań, systemy mogą być bardziej niezależne i elastyczne. To może mieć znaczenie dla sektora przemysłowego, gdzie roboty muszą obsługiwać różne produkty, czy w rehabilitacji, gdzie potrzeba indywidualnych rozwiązań.
Warto jednak pamiętać, że model został przetestowany w środowisku symulowanym i na konkretnych zadaniach. Jego skuteczność w realnym świecie, zwłaszcza w warunkach nieprzewidywalnych, wymaga dalszych badań. Nie jest to jeszcze gotowy produkt do masowego wdrożenia, ale stanowi ważny krok w kierunku bardziej inteligentnych i samodzielnych robotów.
Znaczenie FineART dla przyszłości robotyki wykracza poza techniczne osiągnięcia - to nowa paradigma w rozwoju systemów autonomicznych. Dzięki możliwości zero-shot generalizacji i niskiemu wymaganiu danych, modele takie jak FineART-VLA mogą być szybko wdrażane w różnych sektorach, od produkcji przemysłowej, gdzie roboty muszą obsługiwać różnorodne produkty bez konieczności ponownego programowania, po rehabilitację, gdzie indywidualne podejście do pacjenta wymaga elastycznych rozwiązań. W domu, takie systemy mogą wspomagać osoby starsze lub z niepełnosprawnościami w codziennych zadaniach, adaptując się do ich potrzeb bez konieczności szczegółowego wprowadzania nowych instrukcji.
Choć model został przetestowany w środowisku symulowanym i na ograniczonym zestawie zadań, jego potencjał do pracy w realnym świecie jest istotny - szczególnie gdy rozważa się skalowalność i redukcję kosztów wdrażania. W przyszłości może to prowadzić do tworzenia uniwersalnych robotów, które nie tylko wykonują zadania, ale również uczą się ich wykonywać w sposób zrozumiały dla człowieka, co otwiera drogę do bardziej naturalnej współpracy między ludźmi a maszynami.